
זבל נכנס, החלטות יוצאות: בעקבות הרכישה של אלמנטרי דאטה
רכישת אלמנטרי דאטה מדגישה את האתגר הקריטי של ה-AI הארגונית: אמינות הנתונים המוזרמים לסוכנים ● כשהמודלים הופכים למוצר צריכה חכם, איכות המידע תקבע אם הארגון יפיק תובנות מדויקות או יינזק מהחלטות שגויות




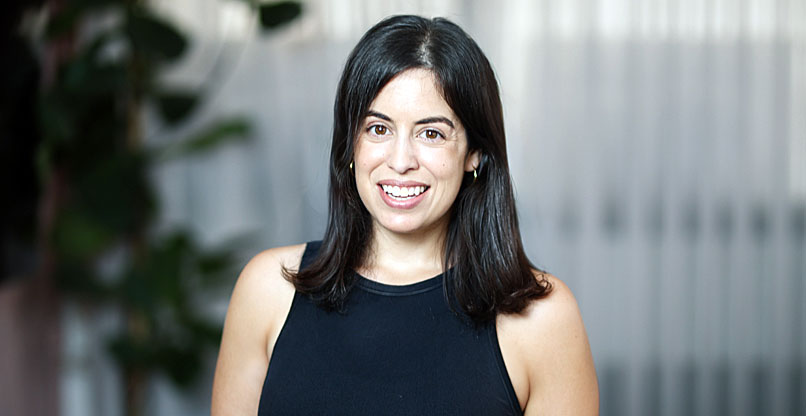
אתמול (ב') הודיעה בומי (Boomi), חברת פלטפורמות אינטגרציה אמריקנית, על רכישת אלמנטרי דאטה הישראלית, תמורת 43 מיליון דולר.
על פניו מדובר בעוד רכישה צנועה של סטארט-אפ ישראלי צעיר. ברם, השאלה המעניינת באמת היא אחרת: מדוע חברה שמחברת בין המערכות של כ-30 אלף לקוחות ארגוניים זקוקה לחברה שכל תפקידה הוא לבדוק אם הנתונים שזורמים בצינורות האלה נכונים? התשובה לשאלה הזאת אומרת לא מעט על הכיוון שאליו הולכת ה-AI הארגונית.
מנכ"ל בומי, סטיב לוקאס, ניסח זאת בהודעה הרשמית במשפט אחד: "ה-AI אמינה רק כמו הנתונים שמאחוריה". זה נשמע כמו סיסמה שיווקית, וכמובן שהיא כזו, אבל מאחוריה מסתתרת בעיה הנדסית אמיתית.
נתונים הם צנרת
כדי להבין את הבעיה צריך לחשוב על נתונים ארגוניים כעל צנרת: המידע זורם ממערכות ה-ERP, ה-CRM, החנויות והאתרים, עובר עיבוד, המרה ואיחוד, ומגיע בסופו של דבר לדו"ח, לדשבורד או למודל. לאורך כל הדרך מפתחים משנים קוד, ספקים מעדכנים גרסאות ומערכות מתווספות. "תשאל מה היו המכירות ברבעון הרביעי ותקבל ממערכות שונות מספרים שונים", הסבירה מעיין סלום, מייסדת שותפה ומנכ"לית אלמנטרי דאטה, בשיחה עם אנשים ומחשבים אמש. "תבדוק היום ותבדוק עוד שבועיים, ותקבל פתאום תוצאות שונות. אנחנו מסתכלים על אותה דאטה, אבל כל הזמן דברים נשברים", ציינה היזמית.
הדוגמה שסלום נתנה ממחישה עד כמה התקלות האלה שקטות. רשת קמעונאות גלובלית ידועה, מלקוחות החברה, קיבלה במשך שנים את נתוני המכירות מהסניף ההולנדי שלה ביורו. אחרי עדכון גרסה שגרתי, המערכת ההולנדית התחילה לשלוח את הנתונים בדולרים, ואילו המערכת המרכזית המשיכה, כמובן, להמיר אותם מיורו לדולר. אף מערכת לא קרסה ואף שרת לא נפל, אבל כל נתוני הסניף ההולנדי השתבשו.
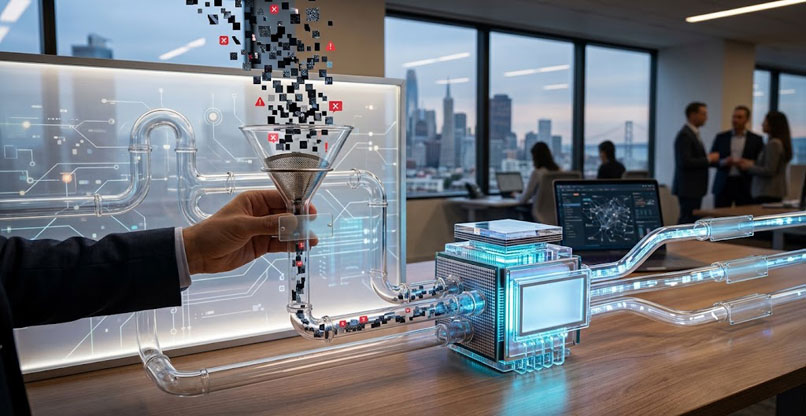
ניטור איכות הנתונים בדרך לקבלת החלטות סוכני ה-AI. צילום: ג'מיני
דוגמה מפורסמת יותר היא זו של טוויטר. במהלך בדיקת הנאותות שקדמה לרכישתה על ידי אילון מאסק עלו טענות שמספרי המשתמשים מנופחים. לפי הגרסה שסיפרה סלום, מקור הבעיה היה שינוי בלוגיקה: חשבון אחד שהיו בו שמונה משתמשים נספר כשמונה חשבונות נפרדים. לא הייתה כאן כוונה לנפח, אלא תקלת נתונים קלאסית, שעלתה ביוקר.
בחברות ציבוריות הבעיה מוכרת היטב, ולא בכדי. אצל חלק מהלקוחות של אלמנטרי, בשנייה שמסתיים דיווח רבעוני לבורסה כבר מתחיל המרוץ לאמת את הנתונים לדיווח הבא.
כשהעין האנושית יוצאת מהלולאה
עד לא מזמן, מי שבדקו את הנתונים האלה היו בני אדם. אנליסט הכין דו"ח, מנהל עבר על המספרים, ומדי פעם מישהו הרים גבה ושאל למה הנתון נראה מוזר. העין האנושית הזאת הייתה שכבת הבקרה האחרונה. "כיום, כולם נותנים ל-AI גישה ישירה לדאטה, ואומרים לסוכן: תעשה הקצאה מחדש של תקציבי השיווק", הסבירה סלום. אם הנתונים שעליהם הסוכן מבסס את ההחלטה שגויים, אין לו כל דרך להגיע לתוצאה נכונה, ויתרה מכך, אין מי שיעצור אותו בדרך.
זה אותו עיקרון ישן של Garbage In, Garbage Out, אבל בקנה מידה ובמהירות אחרים לחלוטין. בעבר, טעות בנתונים התגלתה אחרי שבוע או שבועיים, כשמישהו שם לב. בעידן הסוכנים, עד שמישהו שם לב הסוכן כבר ביצע עשרות פעולות על בסיס הנתון השגוי.
לפי סקר שמומן בידי בומי עצמה, ולכן יש לקחת אותו עם קורטוב של מלח, 86% מהמנהלים מדווחים שהארגון שלהם כבר עבר את שלב הפיילוט עם סוכני AI, אך רק 34% סומכים על הפעולות שהסוכנים מבצעים. ארגונים שהטמיעו סוכנים לפני שהיו מוכנים לכך דיווחו על עלות עודפת ממוצעת של 2.1 מיליון דולר. גרטנר העריכה כבר בתחילת 2025 שעד סוף 2026 ארגונים ינטשו 60% מפרויקטי ה-AI שאין מאחוריהם נתונים מוכנים לבינה מלאכותית, וש-63% מהארגונים לא בטוחים שיש להם בכלל נהלים מתאימים לניהול נתונים בעידן הזה – כך שמה שמאכילים את המודלים הוא קריטי.
ההזיות הן לא רק בעיה של המודל
כאן מגיעה הטענה המעניינת ביותר של סלום. לדבריה, המודלים הפכו כל כך חזקים, עד כדי כך שההבדל בין גרסה לגרסה כבר כמעט לא מורגש, ובמובן מסוים הם הופכים למוצר צריכה. מה שקובע את איכות התוצאה הוא שני דברים: ההקשר שהמודל מקבל ואיכות הנתונים שהוא ניזון מהם. "אתה מקבל תשובה ואומר 'אוף, המודל לא הבין אותי', כי הוא ניזון מנתונים שגויים או שאין לו מספיק קונטקסט", הסבירה. כששאלתי אותה כמה מאיכות התוצאה תלוי באיכות הנתונים הגולמיים, היא סירבה להתקבע על מספר: "אפשר להגיד 60%, 70% או 80%, זה לא משנה. מה שמשנה הוא המגמה".
יש בטענה הזאת מסר ברור למנהלי IT: מי שמחפש את הפתרון לבעיות האמינות של ה-AI הארגונית בהחלפת מודל עלול לגלות שהוא מחפש במקום הלא נכון. וכמובן, יש לבעיה גם צד זדוני, שעליו כתבתי כאן בעבר: הרעלת נתונים מכוונת (Data Poisoning), שהיא, בסופו של דבר, אותה חולשה בדיוק, רק בידיים עוינות.
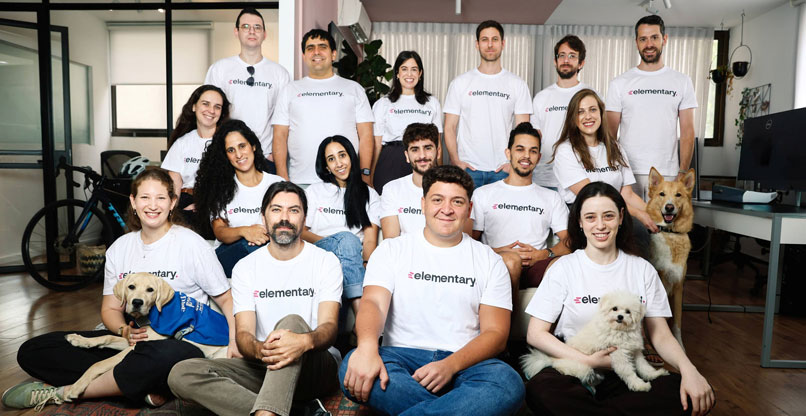
עובדי אלמנטרי דאטה. צילום: ביאנה קארו
מה בעצם בודקים?
אלמנטרי נולדה ב-2022 כפרויקט קוד פתוח, וב-2024 נוספה גרסת ענן מסחרית. לפי נתוני החברה, יותר מ-1,500 צוותי דאטה משתמשים כיום בפתרון שלה, שזוכה לכ-1.1 מיליון הורדות בחודש. סלום משווה את המוצר לכלי ניטור פרודקשן מוכרים: כמו שמנטרים שרתים ועדכונים ליישומים טרום שחרור כדי לדעת אם הם קורסים, אלמנטרי מנטרת את התוכן עצמו. בקצה הפשוט נמצאות בדיקות טריות ונפח, למשל נתון שאמור להתעדכן בכל שעה, ופתאום לא התעדכן במשך חמש שעות.
בקצה המתוחכם נמצאות אנומליות סטטיסטיות: סטיית תקן שהייתה יציבה במשך חודשים וקפצה פי ארבעה, בדיוק אחרי שגרסת קוד חדשה עלתה לפרודקשן. לכך מתווספים מיפוי מסלול הנתונים ברמת העמודה, מהקליטה ועד הדו"ח או הסוכן, ושרת MCP שחושף לסוכני ה-AI את מצב הבריאות של הנתונים, לפני שהם פועלים עליהם.
השאלה הבאה היא מה קורה כשמודלים יתחילו להתאמן על תוכן שמודלים אחרים יצרו, וכשחלק מעיבוד הנתונים עצמו יבוצע על ידי מודלי שפה ולא על ידי קוד דטרמיניסטי. לדברי סלום, העיקרון לא משתנה, רק רמת הבדיקה עולה. אם בעבר בדקו אורך שדה וכמות תווים, כיום צריך לבדוק הקשר ומשמעות. "זה עדיין אותו קונספט של Input ו-Output", אמרה. "זה לוודא שה-Input הוא מה שהוא אמור להיות, שה-Output הוא מה שהוא אמור להיות ולשים את זה בכל השלבים בדרך".
בעידן הסוכנים, אמינות הנתונים כבר אינה עניין טכני של צוות הדאטה, אלא שאלה ברמת ה-C Level של ניהול סיכונים לכלל הארגון. מי שמנטר רק את המערכות ולא את התוכן שזורם בהן יגלה את התקלה כשכבר יהיה מאוחר מדי
מה זה אומר למנהל ה-IT?
המסקנה המעשית פשוטה יותר ממה שנדמה. לפני שמחברים סוכן בינה מלאכותית למערכות הארגון צריך לדעת בדיוק לאילו מקורות נתונים הוא ניגש, מאיפה הם מגיעים ומי אחראי עליהם. כשם שלמערכות יש SLA של זמינות, כך לנתונים צריך להגדיר רמת שירות: באיזו תדירות הם אמורים להתעדכן, מה הנפח הצפוי ואיך נראה המבנה התקין שלהם.
מכיוון שרוב התקלות השקטות נולדות בעקבות שינויי קוד, כדאי לשלב בדיקות נתונים אוטומטיות בכל שינוי שנוגע בצנרת – בדיוק כמו בדיקות התוכנה שכבר רצות ב-CI. במקומות שבהם מודל שפה מעבד, מסכם או ממיר נתונים, יש להשוות בין המקור ליעד, בדיוק כפי שהיו עושים לגבי קוד רגיל. ודבר אחרון, ואולי החשוב מכולם: לא לתת לסוכן הרשאות כתיבה ופעולה בלי שכבת בקרה שיודעת לעצור אותו כשהנתונים שמתחתיו חשודים.
בעידן הסוכנים, אמינות הנתונים כבר אינה עניין טכני של צוות הדאטה, אלא שאלה ברמת ה-C Level של ניהול סיכונים לכלל הארגון. מי שמנטר רק את המערכות ולא את התוכן שזורם בהן יגלה את התקלה כשכבר יהיה מאוחר מדי, ובמקרה של סוכן AI – אחרי שכבר פעל על פי נתונים שגויים או לא טריים.
המודלים כבר מספיק חכמים. השאלה היא אם הנתונים שלכם ראויים להם.
ידיעות מובילות
וואן מרחיבה פעילות במגזר הביטחוני: רוכשת את השליטה בחברת קוביה
"השוק האמריקני רוצה את ההיי-טק שלנו – צריך לדעת להתנהל מולם"
מאפלטון ועד ChatGPT: כל מהפכת ידע מתחילה בחרדה
"ארגונים זקוקים למומחים אנושיים, שיטמיעו AI באופן נכון בליבת המערכות"
600 אלף מסמכים: הארכיון הדיגיטלי שינגיש את מורשת יהדות סלוניקי
תגובות
(0)